




当大模型推理撞上“显存墙”——金融场景下AI存储选型的思考与实践

导读:大模型从百亿向千亿参数迭代时,GPU算力随芯片快速提升,但显存容量增长滞后,算力与存力的“剪刀差”持续拉大,显存已日益成为推理系统的瓶颈。同时,Agent多轮长对话等场景的上下文长度,早已突破显存承载临界点,KV Cache放不下时,要么截断上下文降输出质量,要么重计算浪费算力。某金融企业尝试将KV Cache从现存扩展至外置AI存储,突破显存约束,本文梳理其选型思路、方案设计及预测试沉淀的实用经验,供行业参考。
随着模型从百亿参数向千亿参数持续升级,一个趋势性变化逐渐显现:GPU算力随芯片迭代快速提升,但显存容量增长缓慢。这种算力与存力的“剪刀差”导致一个直接后果:显存日益成为推理系统的瓶颈,而非算力。与此同时,Agent多轮对话、跨工具调用链等新兴场景的上下文长度已突破显存可承载的临界点。当显存无法容纳完整的KV Cache时,推理框架只能选择截断上下文或重新计算,前者影响输出质量,后者浪费算力。这个问题促使团队开始思考:能否通过存储层面的架构调整,将KV Cache从显存扩展到更大容量的存储介质上,从而突破显存容量对推理服务的约束。
问题的答案指向了KV Cache机制与外置AI存储。本文记录了某金融企业在AI存储选型过程中的思考与实践,包括项目背景、方案设计、评估思路及当前阶段的进展。具体测试仍在推进中,但前期的方案设计和预测试已积累了有价值的经验,整理出来供同行参考。
一、项目测试背景与建设需求
1.1 AI业务与智能体项目背景
某金融企业近年来全面推进AI战略,大模型推理已覆盖智能编码助手、智能客服、文档知识库RAG、多轮对话Agent等核心场景。其中智能编码助手是规模最大的推理场景,据团队内部统计,日均服务数千名开发者,输入上下文从早期4K Token增长至35K以上,随着agent的发展,目前已经突破100K以上。
Agent场景对存储的压力更为突出。跨工具调用链、长会话记忆、代码仓库级理解等任务,上下文通常在50K到100K+Token,据企业内部统计输入重复率70%~90%,对首字延迟(TTFT)要求10秒以内,并发量大。这些特征叠加导致KV Cache容量需求呈爆炸级增长,GPU显存已无法满足。
从主流GPU的代际规格可以更清楚地看到这一趋势(见表):
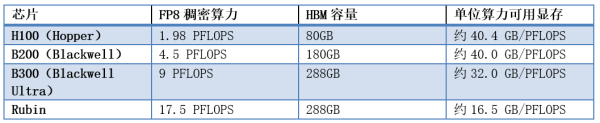
从H100到Rubin四代间,FP8稠密算力提升约8.8倍(1.98→17.5 PFLOPS),显存容量仅提升3.6倍(80→288GB),单位算力可用显存从约40GB/PFLOPS下降至约16.5GB/PFLOPS,降幅约59%。算力增速与存力增速的剪刀差持续扩大。
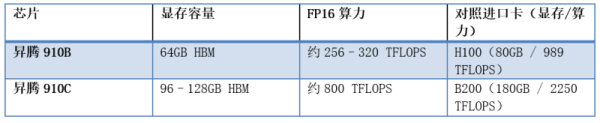
国产算力的引入进一步加剧了这一矛盾。企业国产算力卡占比持续提升,而基于公开规格,国产卡显存容量与带宽均低于同代进口卡,显存约束更紧(见表)。昇腾910B的HBM容量为64GB、FP16算力约256–320 TFLOPS,对照H100(80GB/989 TFLOPS),显存约为其80%,算力约为其26%–32%;昇腾910C的HBM容量为96–128GB、FP16算力约800 TFLOPS,对照B200(180GB/2250 TFLOPS),显存约为其53%–71%,算力约为其36%。整体来看,国产卡显存约为同代进口卡的36%–80%,且算力普遍更低而非更高,单位算力可用的缓存空间进一步收缩,显存约束更为突出。业内将这一趋势称为“算力存力剪刀差”:算力曲线持续上升,存力曲线基本停滞,缺口不断扩大。
这一缺口的直接影响是:KV Cache装不下时,推理引擎被迫丢弃旧缓存,后续请求命中失败后需要重新执行Prefill计算。Prefill阶段的计算量由两部分构成:与上下文长度L成正比的部分(QKV投影、FFN等),以及随L平方增长的部分(注意力矩阵),即C_prefill(L)=a·L+b·L²;当上下文足够长时,平方项成为主导,长上下文场景下的重算代价极为可观。据业务部门观测,Agent多轮对话上下文已突破55K拐点,超过该长度后纯显存方案与分级方案的性能差距将急剧拉大。显存墙并非未来挑战,而是当前亟需应对的现实问题。
1.2整体方案设计中面临的数据与存储需求
大模型推理的Transformer架构中,自注意力机制要求模型在生成每个新Token时回看之前所有Token的Key和Value向量。为避免重复计算,推理框架将这些K、V向量缓存下来复用,即KV Cache。这一机制将推理从“计算密集型”转变为“访存密集型”,但同时也带来了显著的存储空间需求——上下文越长、并发请求越多,KV Cache占用的空间越大。
从业务需求倒推,存储方案需要满足五个核心条件:一是低延迟,KV Cache的访问延迟需要在亚毫秒级,任何额外延迟都会直接影响用户体验;二是高带宽,生产环境真实数据集测试表明,单节点(国产算力卡)KV Cache读写峰值带宽可达10GB/s,集群规模下聚合带宽需求达数十甚至上百GB/s;三是大容量且支持跨节点共享,A节点生成的缓存需要被B节点访问,这对弹性调度和故障迁移至关重要;四是多级缓存协同,热数据需放置在离GPU最近的介质上以降低延迟,冷数据可下沉到更大容量但较慢的介质中以控制成本,数据需根据访问热度在层级间自动流动;五是国产算力适配,这是金融场景下的硬性约束。
1.3为什么需要重新评估现有存储能力
显存不足时,自然考虑将KV Cache卸载到外置存储。经团队对现有存储系统进行评估,发现以下不足:传统存储架构在多个维度上无法满足AI推理的需求。
接口层面,传统存储提供文件或对象接口,而推理框架需要的是以Token块为粒度的KV语义读写。通过文件系统模拟KV操作,每次IO需穿越内核协议栈,延迟远超推理引擎可接受的范围。带宽层面,现有存储的聚合带宽在GB/s量级,与AI推理所需的数十GB/s存在数量级差距。架构层面,传统存储缺乏多级缓存协同能力,无法实现在HBM、DRAM、NVMe和网络存储之间的自动分级。此外,国产算力适配方面也几乎处于空白。
综合以上分析,团队认为引入一种专门面向AI推理场景设计的新型存储方案是必要且紧迫的,这也是启动AI存储选型的直接原因。
二、AI业务方案设计
2.1 AI业务整体技术架构
参考业界KV Cache分级方案,团队设计了一套四层存储架构:L1为GPU的HBM显存,延迟纳秒级,带宽TB/s级,容量百GB级;L2为主机DRAM内存,延迟纳秒级,带宽百GB/s,容量TB级;L3为本地NVMe SSD,延迟微秒级(典型10–100μs),带宽约14GB/s,单节点容量可达十几TB;L4为外置网络存储,延迟亚毫秒级(RDMA优化后可低至60μs),容量可扩展至PB级,支持跨节点共享。
架构设计遵循分级缓存原则:热数据放置在离GPU最近的层级以获得最低延迟,冷数据下沉到容量更大但延迟较高的层级以控制成本。KV Cache在Prefill阶段首先写入L1,随着访问频率降低逐步被卸载;当新请求命中已缓存的KV Cache时,数据从所在层级逐级加载回L1供推理引擎使用。
L1和L2层的管理相对成熟——主流推理框架已具备显存管理和内存池化能力。真正存在技术空白的是L3和L4层,尤其是L4。L4不仅是容量补充,更承担着跨节点共享KV Cache的关键职责,是弹性调度和故障迁移的基础。本次选型的核心目标,就是验证候选的AI存储方案能否胜任L4(或介于L3与L4之间的“L3.5”层)的角色。
2.2数据流转与存储架构设计
KV Cache的数据流转遵循“生成—缓存—复用—淘汰”的生命周期。推理引擎在Prefill阶段生成KV Cache并写入L1;L1容量不足时按LRU策略将冷数据卸载至L2;L2满后继续下沉至L3或L4。当新请求命中已缓存的KV Cache时,数据从所在层级逐级加载回L1,避免重复计算。
架构设计中的一个关键问题是容量与带宽的匹配关系。根据生产环境真实数据集测试,6台A3算力节点组成GPU集群运行GLM5.2模型时,单节点KV Cache读写峰值带宽实测约10GB/s,整集群一天可产生数十TB的KV Cache数据。一台240TB可用容量、160GB/s带宽的AI存储设备,在不同测算口径下的支撑能力差异显著(见表):从带宽视角推算,按单节点峰值实测值10GB/s计算,约可支撑16台推理节点;但是从容量视角推算,根据KV Cache保存周期的不同,可以支持3个GPU集群缓存8小时KV数据或者1套GPU集群缓存3天KV数据。这一测算表明,口径的选择直接影响结论量级,这一判断也深刻影响了后续评估的重点方向。
2.3从业务需求出发,对存储性能、容量、可靠性与扩展性的考虑
基于业务场景的详细拆解,团队整理了一份存储需求量化清单,涵盖性能、容量、可靠性和扩展性四个维度:
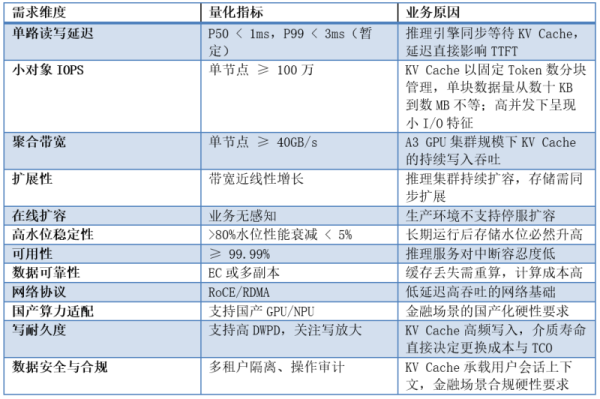
注:以上指标为团队根据自身业务场景制定的设计目标,部分指标参考业界实践。上表“聚合带宽”行的“单节点≥40GB/s”为当前业务情况下,特定算力集群聚合设计目标;单节点KV Cache读写峰值带宽的生产环境实测值约10GB/s,并非通用最佳实践。
该清单成为评估所有候选方案的基准。需要说明的是,延迟指标中P50代表50%的请求能达到的延迟水平,反映系统的典型性能;P99代表99%的请求能达到的延迟水平,反映长尾性能。在KV Cache场景中两者都至关重要:P50决定了大部分请求的用户体验,P99则决定了是否存在周期性卡顿——推理引擎读取KV Cache是同步等待的,即使只有1%的请求出现高延迟,用户也会感知到明显的间歇性卡顿,这种体验上的不稳定对业务影响很大。
2.4候选技术方案的评估思路
市场上面向AI推理场景的存储方案目前可分为三条技术路线:一是原生KV语义路线,绕过文件系统通过RDMA直达NVMe,IO路径最短、延迟最优,但产品成熟度有待验证;二是文件系统模拟路线,在现有分布式存储上叠加KV接口,成熟度较高但IO路径较长;三是软硬一体路线,通过专用DPU和JBOF做加速,性能潜力大但存在厂商锁定。团队前后评估了包括华为AI存储在内的五六家厂商方案,覆盖以上三种路线。
评估框架从六个维度展开:架构合理性(组网冗余、扩展能力、IO路径长短、KV读写是否绕过文件系统直达NVMe)、软件功能(数据服务完整性、CSI容器接口支持)、通用性能(fio基准测试)、KV语义性能(KV读写OPS、延迟分布、批量操作能力,这是核心差异项)、可用性与可靠性(SLA承诺、故障切换机制、介质写耐久度DWPD与写放大)、商务因素(价格、交付周期)。
评估原则是“六维同时达标”——如果一款AI存储能在单路延迟、单节点IOPS、单节点带宽、多节点扩展、在线扩容、高水位稳定性这六个核心指标上同时满足要求,才认为具备进入生产测试的条件。任何一个维度存在明显短板,整体方案的可用性就会存疑。
在候选方案评估中,选择思路主要基于以下考虑:一是商用成熟度,优先选择在企业级存储领域有多年积累、在金融行业有大规模装机记录的方案,其架构设计和可靠性机制已经过生产验证。对于金融机构而言,方案的成熟度和生产验证记录是选型时的重要考量。二是软硬协同设计,从SSD介质到IO路径优化再到前端协议,全栈自研方案理论上可以将IO路径压缩到更短,更适合KV Cache低延迟场景。三是可靠性承诺与AI场景适配,方案需承诺99.99%可用性,并具备KV卸载、多轮PrefixCache重用、RAG加速等AI推理场景特性。四是运维体系复用和生态兼容,优先选择与企业已有存储设备同一生态体系的方案,运维体系可复用,且需兼容各类国产算力平台。
在候选方案中,华为OceanStor A系列是团队计划优先开展POC测试的方案之一。据厂商公开材料,该系列描述了以下能力,团队计划在POC中重点验证:
- 架构方面:采用双控1+1负载均衡,支持Scale-Out横向扩展;
- KV语义支持:DataTurbo前端协议通过RDMA直达NVMe,绕过文件系统内核协议栈;
- KV Cache卸载:提供UCM软件,支持KV Cache卸载存储、多轮对话PrefixCache重用和RAG加速;
- 可靠性:厂商宣称99.999%可用性;
- 国产化适配:采用鲲鹏生态,与企业国产化方向一致。
POC将重点验证原生KV模式下的延迟基线、IOPS峰值、带宽上限、在线扩容表现和高水位稳定性。
三、业界对标:NVIDIA CMX与G3.5层
3.1从“L3.5”设想到G3.5定义
本文2.2节在设计四层存储架构时提出,真正存在技术空白的是介于L3与L4之间的“L3.5”层——它既要有接近本地SSD的延迟,又要具备跨节点共享的容量与网络能力。2026年,这一层级在业界正式落地:NVIDIA在2026年1月CES上首次披露相关技术(当时称为ICMS),并在GTC 2026上随BlueField-4 STX参考架构正式推出CMX(Context Memory Storage,上下文记忆存储)平台,明确定义了存储层级中的G3.5层——一个面向KV Cache优化的、通过以太网挂载的闪存层级,用于弥合GPU内存与共享存储之间的空隙。
3.2 CMX的架构组成与规格
CMX平台的核心组件包括:BlueField-4存储处理器(融合Vera CPU与ConnectX-9 SuperNIC)、DOCA Memos KV通信与存储框架、Dynamo KV块管理器与NIXL(NVIDIA Inference Transfer Library),以及Spectrum-X以太网提供的RDMA网络。硬件规格方面,据NVIDIA官方资料,单2U机箱可提供600TB TLC闪存(4颗BlueField-4各管理150TB),SuperPod内每GPU可分配16TB上下文内存。官方口径显示,通过KV Cache预取(prestaging)减少解码停顿,CMX可使持续Token吞吐与能效最高提升5倍。
CMX的G3.5层与本文四层架构存在清晰的映射关系:G1(GPU HBM)对应L1、G2(系统内存)对应L2、G3(本地SSD)对应L3、G4(共享存储)对应L4,而CMX所定义的G3.5层,正是本文设想的“介于L3与L4之间的L3.5层”。这一映射说明,业界与我们在架构认知上高度一致:KV Cache外置的闪存层,正在成为推理基础设施的标准组成部分。
3.3生态进展与对本文选型的启示
生态方面,CMX计划于2026年下半年出货,AIC、QCT、Supermicro等厂商已推出首批基于该架构的系统。对本文选型工作而言,CMX的发布带来三点启示:一是技术方向得到验证,KV Cache外置到闪存层并非小众探索,而是产业界共识;二是L3.5/G3.5层的性能取决于KV I/O路径设计(RDMA直达、协议卸载)与介质寿命管理,这与本文2.4节评估框架中的架构合理性与可靠性维度一致;三是数据安全能力需要内建,BlueField-4在线速加密与CRC数据完整性保护方面均设有专门加速引擎,这与本文对金融场景加密、隔离与审计的要求相呼应。
NVIDIA CMX的发布验证了KV Cache外置闪存层的产业方向,也为本次选型提供了参考。
四、存储方案评估与阶段性思考
4.1方案评估过程中重点关注哪些问题
厂商提供的规格参数通常是在最优条件下测得的,与实际业务场景可能存在较大偏差。因此,团队决定围绕自身业务的核心关切设计测试方案,而非简单复用厂商的Benchmark。需要回答的具体问题包括:KV语义下单路读写延迟能否达到亚毫秒级?高并发下IOPS和带宽能否同时打满?多节点并行是否存在资源争抢?高水位下性能是否稳定?国产算力环境下能否正常运行?
针对这些问题,团队设计了六个测试场景,覆盖从基线到极限的完整性能图谱。
场景一:单路读写延迟基线。使用单Worker、单队列深度,测试4K Token块(单块数据量数十KB至数MB)的PUT和GET操作。该场景在无任何并发优化的条件下评估存储系统的底层延迟功底,是所有后续测试的基础。关键观测指标是P50和P99延迟——P50反映典型性能水平,P99反映长尾控制能力。推理引擎对长尾极为敏感,若P50为0.5ms但P99达到20ms,说明系统存在偶发的高延迟请求,这类间歇性卡顿在多轮对话中会被用户明显感知。
场景二:单节点高并发吞吐。在单节点上逐步增加并发数和队列深度,观察IOPS和带宽的爬坡曲线,定位性能拐点。KV Cache的IO以固定Token数分块的小对象为主,单块数据量从数十KB到数MB不等,该场景重点验证存储系统在高并发小IO下的处理能力。
场景三:多节点并行扩展。使用多个客户端同时施加负载,验证聚合带宽是否接近单节点的线性扩展。该场景能有效暴露集群内部互联带宽不足、锁竞争、元数据瓶颈等隐藏问题。若多节点性能未达到单节点的1.8倍以上,则说明扩展性存在约束。
场景四:在线扩容。模拟生产运维场景,在存储系统承载业务的同时插入新盘,观察重平衡启动时间、持续时间、过程中的性能波动及是否存在业务中断。该场景对评估方案的运维成熟度具有重要参考价值。
场景五:高水位稳定性。将存储水位从50%逐步提升至80%、90%、95%,观测性能衰减曲线。生产环境的存储系统长期运行在70%以上水位,部分方案在低水位时性能表现优异,但在高水位下出现断崖式下跌。不验证高水位性能就部署到生产环境,存在较大风险。
场景六:多租户隔离与数据安全验证。KV Cache承载用户会话上下文,属于敏感数据。在存储集群被推理服务与批处理任务共享时,需验证多租户QoS隔离是否有效(高优先级业务不因低优先级任务而劣化),同时验证静态与传输加密、权限隔离与操作审计等安全机制是否满足金融场景合规要求。
测试环境方面,搭建了3节点存储集群,配置双100Gb RoCE网络,总容量167TB。测试客户端2个节点,配置与存储节点类似的处理器和内存。
4.2当前重点验证的能力与场景
在上述测试场景中,当前阶段重点推进以下三个方向的验证:
一是KV语义下的延迟基线。这是评估的基础——若单路P50无法达到1ms以内,后续优化空间将非常有限。重点验证GET操作的延迟分布,因为推理引擎读取KV Cache是同步等待的,P99一旦超过10ms,用户即可感知到响应卡顿。同时关注P50与P99的比值,该比值反映了延迟分布的均匀程度,比值越接近1说明系统越稳定。
二是多节点聚合带宽的线性度。单节点性能达标只是起点,多节点并行时是否会出现资源争抢导致性能下降才是关键。验证两个指标:聚合带宽是否接近N倍单节点性能(验证扩展性),以及多节点同时施压时单节点性能是否下降(验证资源隔离)。
三是高水位下的性能稳定性。这是最接近生产现实的测试维度。重点观测80%和90%水位下,P50、P99延迟分布和IOPS是否有显著变化。理想情况下,高水位的性能衰减应控制在5%以内。
此外,国产算力环境下的兼容性和实际性能表现也是必须验证的方向。不能仅凭厂商的兼容性声明做判断,需在国产算力环境中进行实测验证——“兼容”与“性能达标”之间可能存在显著差距。
4.3现阶段的观察与仍需关注的问题
正式测试仍在推进中,但前期的方案设计、厂商交流和预测试阶段已积累了一些有价值的观察。
在方案评审过程中,三条技术路线的特征逐渐清晰。原生KV语义方案在延迟上具有天然优势,IO路径最短,但作为新兴方向,产品在大规模生产环境中的长期稳定性还需验证。文件系统模拟方案基于成熟的分布式存储改造,交付和运维体系相对完善,但IO路径较长带来的延迟开销是其固有短板。软硬一体方案通过专用硬件加速,性能潜力最大,但对厂商的依赖程度也最高。三条路线各有取舍,最终选择需要实测数据支撑。
带宽与容量的关系是另一个重要观察。如前文测算(按单节点峰值实测10GB/s口径),一台200TB、160GB/s的AI存储设备,从带宽角度仅能支撑约16台推理节点,带宽是系统扩展的主要性能约束。但同时,容量同样具有重要业务意义——它决定了KV Cache数据能在存储层保存多长时间。容量越大,缓存可保留的时间窗口越长,跨会话和跨用户的缓存复用概率就越高,对推理吞吐的整体提升也越显著。因此,选型时带宽和容量需要兼顾评估:带宽决定了系统能同时服务多少推理节点,容量决定了缓存数据的有效保留时长。两者共同影响KV Cache命中率和整体推理效率。
分级缓存的验证也带来了正面信号。据团队内部测试,在L1+L2两级缓存的测试中,随机数据集测试情况下,缓存命中率从40%提升到70%时,推理吞吐实现了近一倍的增长。这一结果增强了团队对L3或L4层引入后性能潜力的信心。但需要指出的是,L4层存储必须具备足够低的延迟和足够高的带宽,否则数据在层级间搬运的开销将抵消分级缓存带来的收益。
五、总结
回顾这段工作,有几点思考值得记录。
第一,带宽与容量需协同评估。在KV Cache存储选型中,带宽决定了系统能同时服务的推理节点数量,容量决定了KV Cache数据的有效保留时长。两者不可偏废——带宽不足会导致推理节点等待,容量不足会导致缓存过早淘汰、命中率下降。选型时应根据集群规模和业务会话特征,找到带宽和容量的合理配比。
第二,延迟分布比均值更重要。KV Cache场景下,P50反映典型性能水平,P99反映长尾控制能力。推理引擎读取KV Cache是同步等待的,即使只有1%的请求出现高延迟,用户也会感知到间歇性卡顿。评估存储方案时,P50和P99需要同时达标,且两者的比值越接近1,说明系统越稳定。
第三,高水位性能必须验证。部分存储方案在低水位时性能表现良好,但在80%以上水位时出现显著衰减。生产环境的存储系统长期运行在高水位状态,不在高水位条件下进行测试就部署生产,存在较大风险。
第四,厂商性能数据仅供参考,POC实测是唯一可靠依据。各厂商宣称的性能指标通常是在各自最优条件下测得的,测试条件、负载模型和对比基线各不相同,直接横向比较容易得出错误结论。同等条件下的POC实测是评估方案真实能力的有效方式。
第五,国产算力适配需要实测验证。国产化是金融场景的硬性约束,但厂商的兼容性声明与实际性能表现之间可能存在较大差距。不能仅凭“支持”的表述做判断,需在国产算力环境中进行完整的性能测试。
第六,方案成熟度与先进性需平衡取舍。新兴方案可能在技术理念上更为前沿,但在金融生产环境中,方案的成熟度和大规模生产验证记录同样重要。这一权衡没有标准答案,取决于企业的风险偏好和业务容错能力。
总结来看,本次AI存储选型的核心工作可以概括为:识别显存瓶颈的根源,分析传统存储的不足,设计系统化的评估方案来验证候选方案,并选定了重点测试方向。整个过程更多是工程层面的严谨验证,而非技术突破。在AI基础设施建设中,基于实测数据做决策,而非依赖厂商提供的规格参数,是控制风险、保障业务稳定运行的基本原则。